Da una lista di link a una raccolta di file privati
Un servizio di bookmarks, nella sua forma classica, è una lista di link: titolo, indirizzo e qualche etichetta. Adesso mi serviva di più: mp3 e pdf, come podcast sintetizzati per lo studio e le loro dispense, da ascoltare e rileggere tenendo il segno di dove sono arrivata, da condividere con poche persone e da tenere lontani da tutte le altre.
Dal 1998 i miei bookmarks sono pubblici, e la versione precedente, bookmarks-v3.0, era un sito statico generato da Jekyll e pubblicato su GitHub Pages: costava zero, e per una lista di link pubblici era quanto basta. Il criterio è rimasto lo stesso, spendere il meno possibile, ma con un vincolo nuovo: i dati devono restare privati. Per tenerli privati servono due cose: pagine che chiedono i dati solo dopo il login e un hosting che protegge quelle pagine. Alla v3.0 mancano entrambe:
- GitHub Pages: è l’hosting, e serve gli stessi file a chiunque. Non permette di impostare header HTTP: una Content Security Policy (CSP) si può mettere solo dentro la pagina, in forma ridotta, e mancano gli header che vietano di inserire la pagina in un altro sito, che obbligano HTTPS e che non passano ad altri siti l’indirizzo da cui si arriva. E siccome serve solo file statici, non può ospitare un’API, che dovrebbe quindi stare su un’altra origine
- Jekyll: è il generatore, e crea le pagine al momento della build, quindi una pagina contiene solo quello che c’era allora, e dei dati privati non possono entrare in una build pubblicata. In più, fuori da GitHub Pages, che lo esegue da sé, Jekyll vorrebbe dire tenere aggiornati Ruby e le sue gem
Le altre strade le ho scartate per motivi più banali. Avevo due repository miei pensati proprio per un sito statico con le sue risorse, aws-static-website e aws-static-gui-resources: da febbraio 2022 sono fermi su AWS Cloud Development Kit (CDK) v1, che da giugno 2023 è fuori supporto, e il loro bucket è pubblico, cioè esattamente l’opposto di quello che mi serviva. Rinnovarli voleva dire riscriverli.
Sei scelte, tutte per tenere i dati dove devono stare
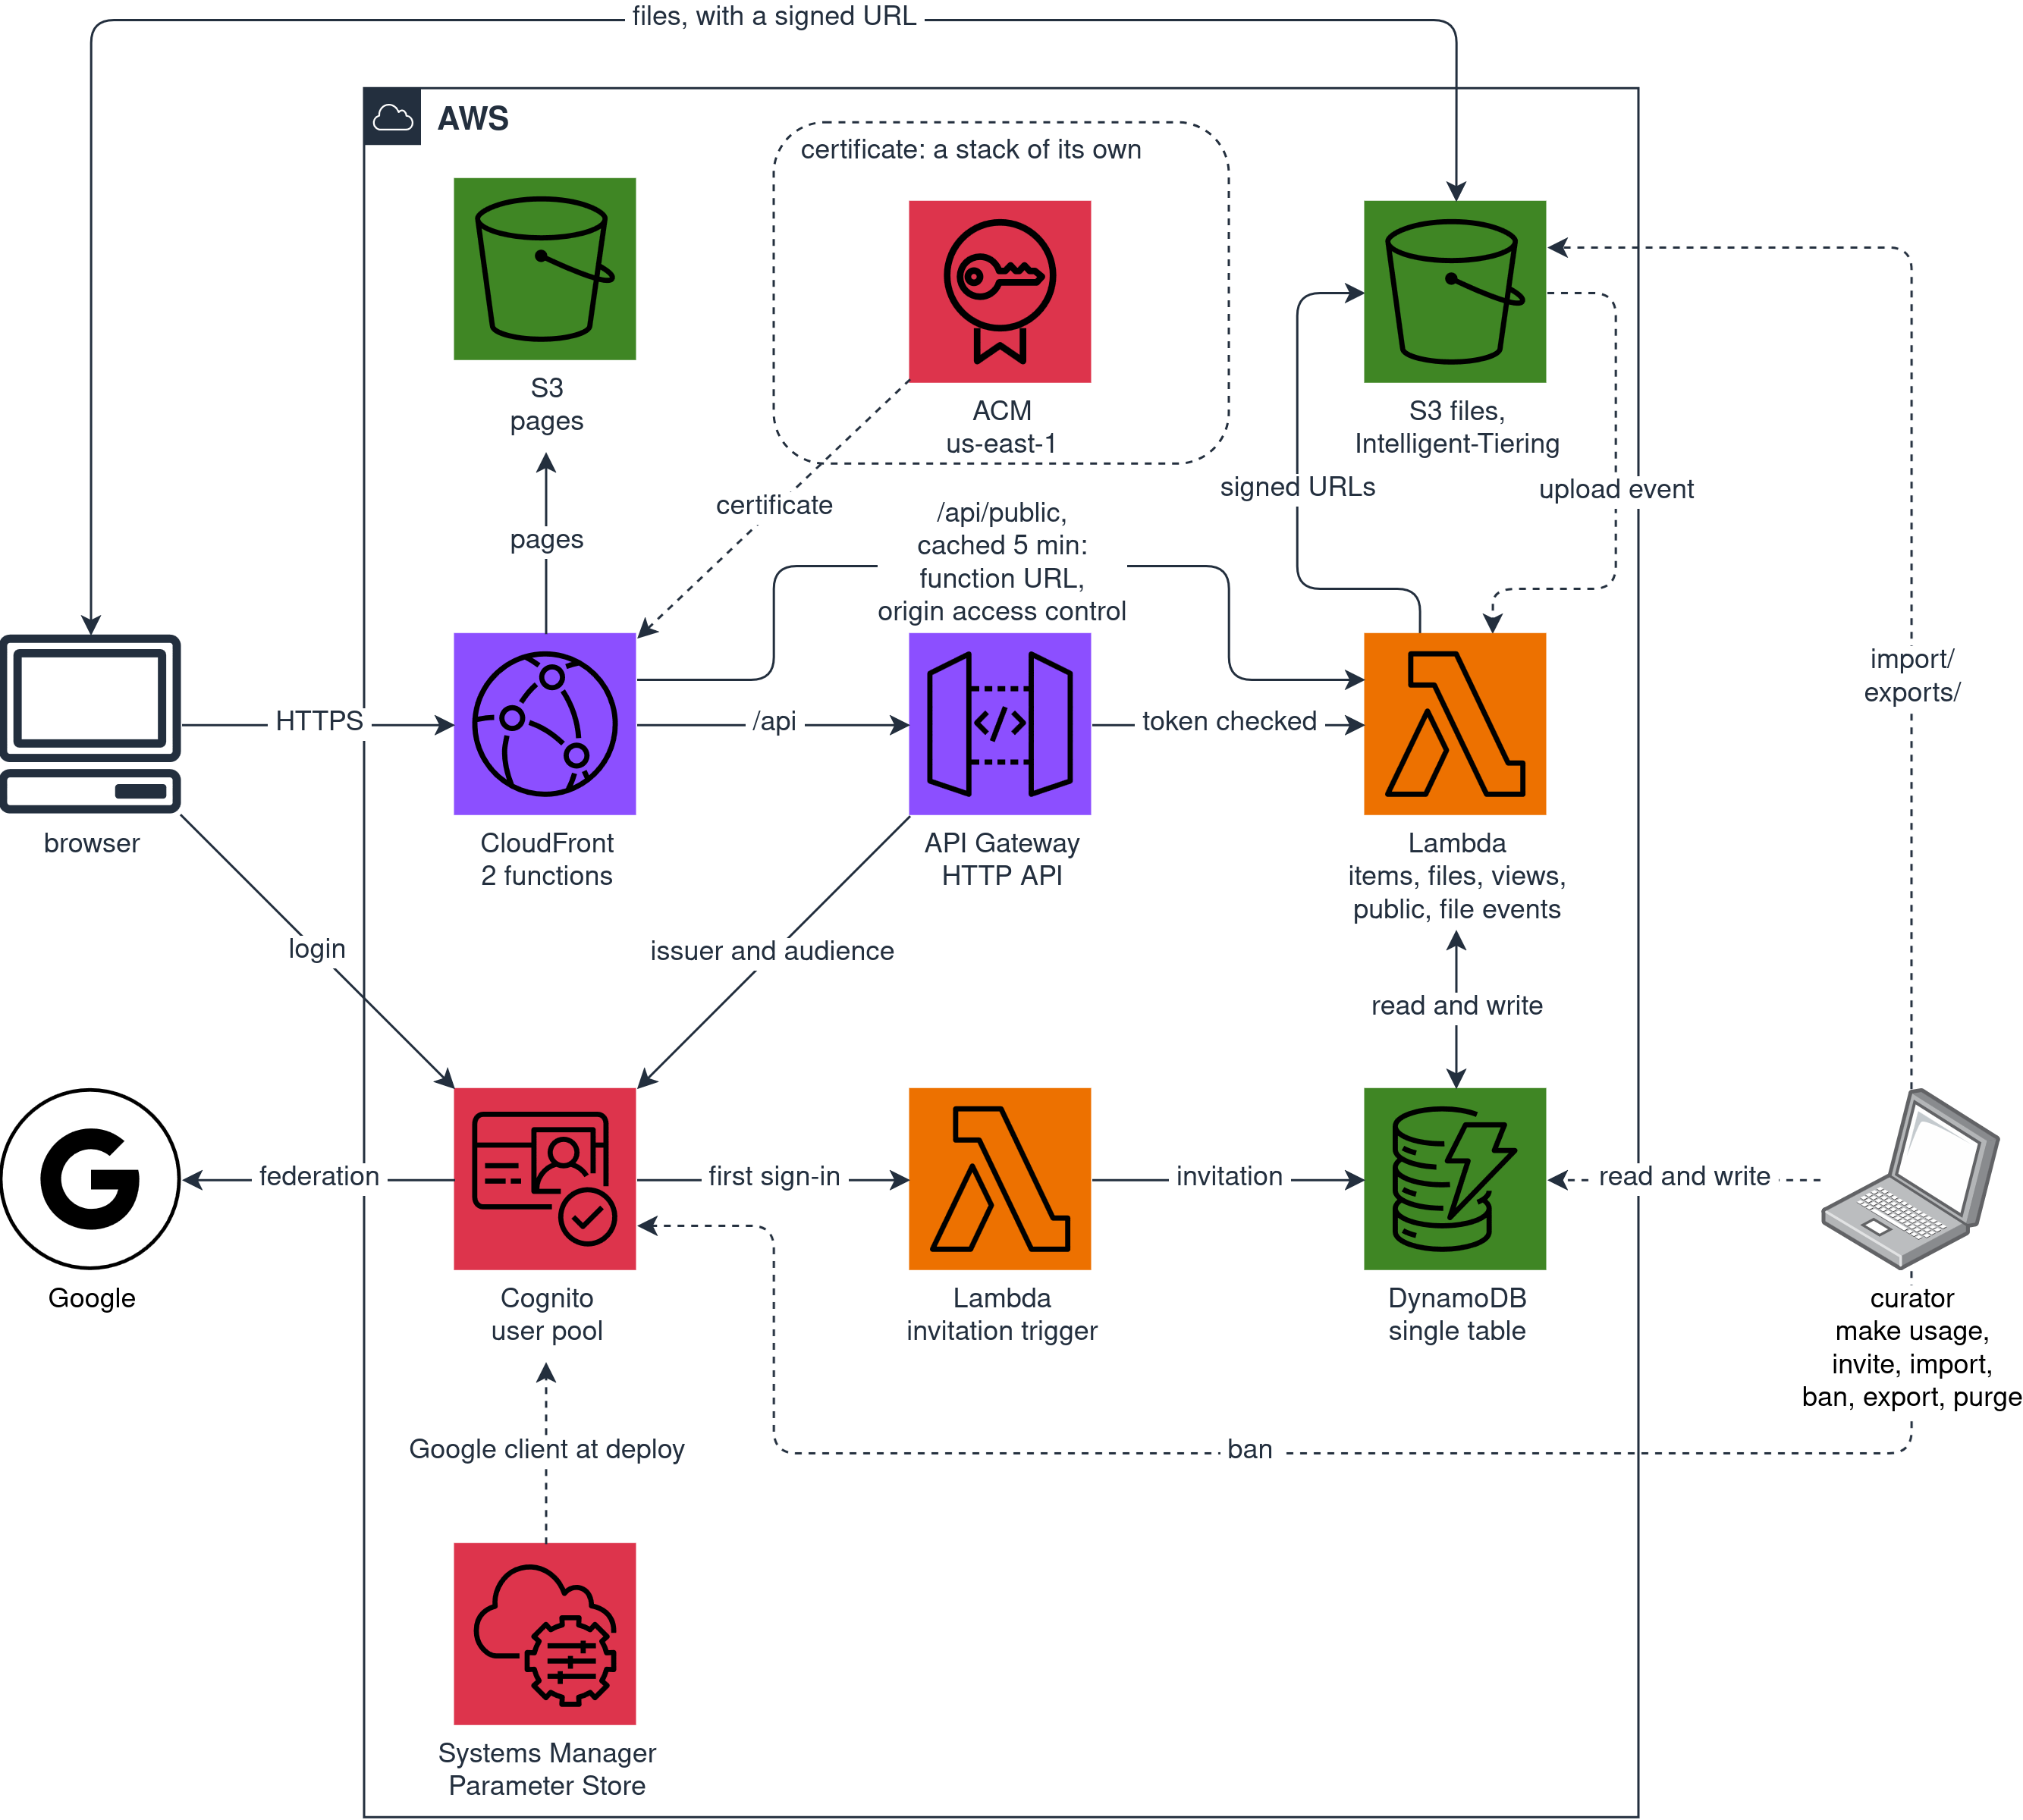
Da buon developer pigro, sono partita da quello che avevo già fatto e che funzionava: aws-card-clash, il sito per la gestione di tornei scritto con AWS Serverless Application Model (SAM) e TypeScript, che aveva già un bucket privato dietro Amazon CloudFront, un controllo dei token all’ingresso dell’API (authorizer), Amazon Cognito federato con Google e una tabella Amazon DynamoDB unica. La differenza è che lì un accesso non autorizzato permetteva al massimo di vedere un torneo; qui permetterebbe di aprire i file di un’altra persona. Ogni scelta è pesata su questo. Il funzionamento delle pagine, i comandi e i costi sono nel README.
CloudFront, senza Route 53
Il sito doveva stare in un bucket privato e mandare gli header di sicurezza nella risposta HTTP. Le alternative erano restare su GitHub Pages, gestendo l’API su un altro dominio, oppure passare a CloudFront.
Ho scelto CloudFront davanti a un bucket privato di Amazon Simple Storage Service (S3). Con Origin Access Control il bucket lo legge solo la distribuzione, e l’API risponde sotto /api, sulla stessa origine del sito. Così tra sito e API non serve Cross-Origin Resource Sharing (CORS), la CSP è completa, impostata in una regola di header della distribuzione (response headers policy), e per cambiare il sito servono le credenziali AWS, non basta un push.
Costa uguale, cioè zero, perché il piano gratuito di CloudFront copre un terabyte al mese. Amazon Route 53 invece non l’ho usato: la zona DNS ospitata (hosted zone) costa 50 centesimi al mese, e al suo posto bastano due record CNAME scritti a mano nel DNS che avevo già, uno per validare il certificato di AWS Certificate Manager (ACM), che è gratuito, e uno che fa da alias del nome del sito verso la distribuzione.
Solo su invito, e token che durano poco
Chi entra deve essere qualcuno che ho invitato. Le alternative erano email e password gestite da Cognito, oppure il login con Google: ho scelto Google, perché così non conservo password di nessuno e, diciamolo, perché con aws-card-clash era gratis. La lista degli invitati sta in DynamoDB, e a leggerla è un trigger di pre sign-up: una funzione AWS Lambda che Cognito chiama prima di creare un utente, e che rifiuta ogni indirizzo senza invito.
Poi c’era da decidere dove tenere i token. L’alternativa più robusta sulla carta erano i cookie HttpOnly, che uno script nella pagina non può leggere; ma uno script nella pagina non ha bisogno del token per leggere i dati privati, li legge con la sessione della pagina stessa. Il cookie avrebbe evitato solo la copia del token, al prezzo di scrivere a mano login, rinnovo e logout.
Ho scelto il sessionStorage con le durate minime di Cognito: cinque minuti per il token e un’ora per il rinnovo. A differenza del localStorage, il sessionStorage sparisce con la scheda: chiudere la pagina chiude la sessione, e un token copiato vale al massimo un’ora.
La difesa vera è rendere improbabile che uno script arrivi nella pagina: una CSP che accetta solo il codice del pacchetto dell’applicazione (bundle), senza codice in linea e senza eval, i testi inseriti sempre come testo e mai come HTML, e solo link http e https.
Monitorare invece di limitare
Chi carica file genera costi, e chi ha fatto il deploy deve sapere chi costa quanto. Le alternative erano quote per persona, una dimensione massima, oppure lasciar caricare solo il curatore.
Ho scelto di non limitare nessuno e di contare: ogni download conta una richiesta e i byte del file, ogni caricamento i suoi byte, e ognuno vede i propri consumi con i costi accanto. Le persone sono poche e invitate da me, perciò mi basta sapere chi costa quanto, senza scrivere un sistema di quote da tenere in piedi.
Da buon developer pigro, i prezzi non li ho scritti nel codice: il deploy li legge da solo dalla AWS Price List Query API e li passa alle Lambda. Se AWS cambia il nome di una voce del listino e un prezzo non si trova, il deploy si ferma invece di mostrare un costo pari a zero.
La gestione dei file
Un mp3 da trenta minuti pesa decine di megabyte. Le alternative erano servire i file dall’API, oppure dare al browser un accesso diretto a S3. Dall’API non si può: una Lambda risponde al massimo con 6 MB, e anche restando sotto quel limite si pagherebbe il tempo di ogni download.
Ho scelto gli URL firmati: la Lambda dei file controlla chi può avere il file e firma un indirizzo che dura quindici minuti per il caricamento e un’ora per il download, quanto basta per ascoltare un podcast con qualche pausa; il browser parla direttamente con il bucket, che resta privato.
Proprio perché il file va dal browser al bucket senza passare dal backend, il backend non sa se il caricamento è finito, né quanto pesa davvero il file: il browser potrebbe interrompersi, o dichiarare una dimensione falsa. Lo sa solo S3, che a caricamento avvenuto manda un evento con la dimensione reale: è quello a segnare il file come pronto e a contare i byte caricati per il monitoraggio. Da lì in poi, ogni URL firmato per il download conta la dimensione registrata dall’evento.
Fin dal caricamento, i file stanno in Amazon S3 Intelligent-Tiering, e quelli che nessuno apre scendono da soli su una classe più economica, senza regole di ciclo di vita (lifecycle) da scrivere.
Una pagina pubblica a costo fisso
Alcuni link devono essere visibili a tutti, senza login, ed è l’unico punto del sistema aperto a chiunque. Le alternative erano un percorso pubblico dell’API (route) servito dalla stessa Lambda delle altre, oppure una Lambda a parte.
Ho scelto una Lambda a parte, così il suo ruolo può solo leggere, e la risposta contiene titolo, link, tag e niente altro. Soprattutto, davanti alla Lambda c’è una regola di cache di CloudFront (cache policy), che tiene per cinque minuti la risposta di quel solo percorso. Mille visite in cinque minuti diventano una chiamata a Lambda e una lettura di DynamoDB per ogni punto di presenza di CloudFront (edge location) da cui arrivano, qualunque sia il traffico.
Il prezzo è che una pubblicazione compare, o sparisce, con fino a cinque minuti di ritardo, che per dei link pubblici in un sito personale va benissimo.
La cache però protegge solo chi passa da CloudFront: l’HTTP API di Amazon API Gateway ha anche un indirizzo suo, raggiungibile direttamente, e una route aperta fa arrivare alla funzione ogni richiesta. È la porta per un attacco che non vuole far cadere il servizio, ma far crescere il conto (denial of wallet). All’inizio l’avevo gestita con un limite di richieste sulla route (throttling): una richiesta al secondo, con un picco di cinque. Tuttavia questa soluzione non chiude quella porta.
L’ho chiusa dando alla funzione un indirizzo suo (function URL), protetto da Origin Access Control come il bucket delle pagine: CloudFront firma ogni richiesta, e una chiamata che non viene dalla distribuzione riceve un errore 403 prima che la funzione parta, e il test mostra che non diventa mai un’invocazione, cioè non si paga. La route dell’HTTP API resta, dietro l’authorizer come tutte le altre, solo per le prove in locale, dove il function URL non c’è.
Consegnare i dati senza lasciarli in giro
Quando una persona viene allontanata, i suoi dati vanno cancellati, ma prima vanno consegnati a lei. Le alternative erano mandarle i file a mano, oppure prepararle un archivio.
Ho scelto uno zip su S3, raggiungibile con un URL firmato che dura sette giorni, e nel formato dell’import, così che la persona possa ricaricarlo in un sistema suo.
Poi una regola di lifecycle sul prefisso degli export cancella lo zip dopo sette giorni, la stessa durata del link. S3 conta i giorni dalla creazione e arrotonda alla mezzanotte UTC successiva: lo zip può sopravvivere al link fino a un giorno. Dalla scadenza dello zip non si paga più e non resta niente da ricordarsi di cancellare.
Cosa non avevo previsto
Partendo da una base già pensata, le sorprese sono state poche: tre, e nessuna nel codice dell’applicazione.
I container che non se ne andavano
In locale le Lambda girano con sam local, che per ogni chiamata crea un container nuovo, e una pagina ne fa sei. Con i warm container, che restano accesi tra una chiamata e l’altra, i test automatici dell’API si velocizzano parecchio. Solo che, a test finiti, restavano dei container accesi, per due motivi.
Il primo: lo script dei test, local/api-check.sh, lancia sam local in background con &, e SAM spegne i suoi container solo quando riceve SIGINT, il segnale di un Ctrl+C. Però POSIX fa ignorare SIGINT ai processi lanciati con & da uno script, e il segnale, pur arrivando, veniva scartato. Il comando env, con --default-signal=INT, rimette SIGINT al suo comportamento normale prima di lanciare SAM, e da lì lo script lo spegne come si deve.
Il secondo: di base sam local non tiene acceso nessun container, e i warm container vanno chiesti con --warm-containers, che ha due modalità. Avevo scelto EAGER, che li crea tutti all’avvio e che però, con gli stack annidati, ne crea uno doppio alla prima chiamata, e alla chiusura spegne solo uno dei due. LAZY, che li crea alla prima chiamata, non ha il problema.
Con queste due modifiche, a test finiti non resta nessun container.
Un link di sette giorni che dura un pomeriggio
Per l’export avevo previsto un URL firmato di sette giorni, il massimo che S3 permette. Rileggendo la documentazione degli URL firmati prima di scriverlo, la sorpresa: un URL firmato vale finché valgono le credenziali che l’hanno firmato.
Con credenziali temporanee, cioè Single Sign-On (SSO), un ruolo assunto o il profilo di un’istanza, il link scade con la sessione, dopo qualche ora, anche se si chiedono sette giorni. E una Lambda non risolve, perché anche il suo ruolo ha credenziali temporanee. A conti fatti, chi segue le buone pratiche si ritrova con un link che dura un pomeriggio.
Le strade per avere davvero sette giorni sono tre:
- un utente dedicato di AWS Identity and Access Management (IAM): con chiavi di accesso (access key) a lungo termine e il solo permesso di leggere gli export, è la più semplice, ma sono proprio le chiavi che la buona pratica sconsiglia, e il tetto resta di sette giorni
- un URL firmato di CloudFront: la firma non viene da IAM, ma da una coppia di chiavi creata apposta. La chiave pubblica si registra sulla distribuzione, la privata la tiene chi firma. Siccome la firma non dipende da nessuna sessione, la scadenza può essere quella che si vuole. Costa zero, perché le chiavi sono gratuite, il traffico rientra nel piano gratuito di CloudFront e la chiave privata può stare in un parametro standard di AWS Systems Manager Parameter Store, gratuito. In cambio, lo zip va servito da CloudFront invece che da S3
- un link che rigenera il link: si manda alla persona l’indirizzo di una route dell’API con un codice, salvato con una scadenza di sette giorni, per esempio con il Time To Live (TTL) di DynamoDB. A ogni apertura, una Lambda controlla che il codice non sia scaduto e che lo zip esista ancora, e firma al momento un URL di S3 di pochi minuti. Le credenziali temporanee bastano, perché ogni firma è fresca
Un certificato bloccato da GitHub, e un nome che c’era ma non si trovava
Il sito doveva stare su bookmarks.alessandra.bilardi.net. Scritto il record di validazione nel pannello DNS, il certificato è rimasto in attesa. Il record era giusto: i server DNS pubblici (resolver) di Google e di Cloudflare rispondevano con il valore atteso.
I colpevoli erano i record Certification Authority Authorization (CAA), che dicono quali autorità possono emettere un certificato per un nome: se il nome non ne ha, si sale al dominio sopra, seguendo i CNAME. E alessandra.bilardi.net è un CNAME verso le mie GitHub Pages, i cui CAA ammettono Let’s Encrypt, DigiCert e Sectigo, ma non Amazon.
L’unico posto dove aggiungere un CAA che ammettesse Amazon era il nome del sito stesso, perché su alessandra.bilardi.net, che è un CNAME, non si può aggiungere nient’altro. Tuttavia anche il nome del sito doveva diventare un CNAME, verso CloudFront, con lo stesso limite: un CNAME non convive con altri record, quindi il CAA sarebbe dovuto sparire proprio quando il sito fosse andato online, e il primo rinnovo, che ricontrolla i CAA, sarebbe fallito.
Così il sito è finito su bookmarks.bilardi.net, dove i CAA non ci sono. Per il futuro resta un vincolo: se un giorno aggiungerò dei CAA su bilardi.net, per un’altra autorità, dovranno ammettere anche Amazon, altrimenti il rinnovo del certificato di bookmarks fallirà.
A certificato emesso e secondo CNAME scritto, i controlli fallivano ancora, con Could not resolve host: il resolver del mio computer aveva chiesto il nome durante il deploy, prima che il record esistesse, e teneva in memoria la risposta “non esiste”. Il sito rispondeva già, bastava forzare l’indirizzo di CloudFront per vederlo. Non so quante volte ormai mi sia capitato: resolvectl flush-caches svuota la cache, e tutto va a posto.
E se diventasse un servizio ?
Il sistema così com’è è quanto basta per me e per le poche persone che invito. I dati privati sono delicati comunque, miei o di altri; un servizio, invece, andrebbe offerto e garantito a persone che non conosco.
Cosa serve per offrire un servizio ?
- Termini e condizioni: il curatore vede i dati di tutti, per poter aiutare quando qualcosa va storto. Tra persone che si conoscono basta dirlo nel footer delle pagine; per degli sconosciuti servirebbero dei termini da accettare, e un accesso limitato ai casi di necessità
- Le quote: tra poche persone basta contare i consumi; in un servizio servirebbero una quota per persona e una dimensione massima dei file, per non pagare io quello che carica qualcun altro
- I prezzi aggiornati da soli: oggi i prezzi si aggiornano solo quando rifaccio il deploy; da buon developer pigro, li farei rileggere ogni mese dalla Price List Query API a una Lambda schedulata, che ne conserverebbe lo storico, perché ogni mese venga stimato con le tariffe in vigore allora
- L’export dalle pagine: oggi è il curatore a consegnare i dati di una persona; in un servizio ognuno dovrebbe poterli scaricare da sé, in qualunque momento
- Una Command Line Interface (CLI) per chi usa il servizio: per esempio per l’import dei propri bookmarks, che oggi può fare solo il curatore. L’API accetta qualunque client con un token valido del pool, per cui basterebbero un login dal terminale e un indirizzo di ritorno in più su Cognito, senza toccare il backend
Cosa serve per garantire un servizio ?
- Una cache lunga, sempre aggiornata: cinque minuti sono un compromesso, perché un link tolto per sbaglio dalla pagina pubblica resta visibile per tutto quel tempo. Con più curatori o più traffico conviene una cache di un giorno, invalidata ogni volta che si pubblica o si toglie un link: le prime mille invalidazioni al mese sono gratuite, e alla Lambda degli elementi servono il permesso di farle e l’identificativo della distribuzione
- Le dipendenze da seguire: aggiornarle con regolarità chiude i bug già noti, ma una versione nuova può portarne di suoi, o essere stata compromessa. Conviene l’ultima versione stabile, non quella uscita il giorno stesso: una versione compromessa, quando viene scoperta, viene ritirata, e aspettare qualche giorno dà il tempo che succeda
- I cookie firmati di CloudFront: con gli URL firmati, un link copiato apre il file finché non scade; con i cookie il link da solo non apre niente. Costano una coppia di chiavi da custodire e un percorso in più nella distribuzione, che non costa niente; la chiave privata può stare in un parametro SecureString standard di Parameter Store, gratuito, come il segreto del client Google
- Il controllo delle intrusioni: registrare le letture dei file non impedisce nulla, ma permette di scoprire dopo chi ha letto cosa; il passo successivo è una Lambda che legge quei registri e segnala le letture anomale
- Un ban immediato: oggi chi viene allontanato conserva il token che ha già, per cinque minuti al massimo, perché l’authorizer controlla la firma del token con una chiave pubblica che tiene in memoria e non chiede a Cognito se l’utente esiste ancora. Controllare l’invito a ogni chiamata chiuderebbe anche quei cinque minuti, al costo di una lettura della tabella per richiesta
Nessuno di questi punti richiede di rifare l’architettura: sono tutti pezzi da aggiungere a quella che c’è, il giorno in cui servono.